新加坡国立大学(NUS)BMS5121 · 原型冲刺 · 第 1 组 · 2026
Kopi & Co
四十分钟,准备好一场周一会议。
一个面向区域连锁咖啡店的决策支持原型:从十二周的门店数据中找出问题,帮助管理者准备周一会议。
- 40
- 分钟准备时间
- 42
- 家门店
- 12
- 周数据
- 03
- 项核心决定
阅读工具 / 看懂,也串起来
这篇内容里的几个概念。
展开一个概念,看看它在这里的含义,以及另一个领域如何提出相近的问题。
约束
限制会改变真正可选的方案。先看哪些选择能够执行,再比较哪个最值得做。
在这篇内容中:先确定周一会议真正需要解决什么。
- 一次进站的代价。 新胎优势必须在剩余圈数内收回进站成本。
- 准备之后,还要等一口。 充分准备仍然需要遇到合适的机会窗口。
证据
把观察、解读和模型分开。它们都能帮助理解问题,但能够支持的结论并不相同。
在这篇内容中:查看已公开原型界面,以及这些证据能够说明什么。
- 一次进站的代价。 把官方赛报中的事实与示例模型分别核对。
权衡
改善一件事可能需要付出另一种代价。先看清交换了什么,再判断它是否真的更好。
在这篇内容中:先说明优先级和限制,再决定处理哪些问题。
- 一次进站的代价。 用眼前的赛道位置,交换之后的圈速优势。
迭代
下一次尝试应当有理由地改变一些东西。不只留下最新结果,也保留促成调整的观察。
在这篇内容中:看看制作和检查原型后,我有哪些反思。
- 准备之后,还要等一口。 分清哪些操作下次能改好,哪些结果还要看运气。
模型边界
模型能回答什么,取决于它怎样描述问题。在把结果用于真实决策之前,先说明它省略了什么。
在这篇内容中:看看原型里的建议,还需要哪些现场信息才能执行。
- 一次进站的代价。 模型里的追及,不等于真实超车或获胜。
- 准备之后,还要等一口。 假设的每窗成功率,不是鱼类的实测掉率。
任务约束
一个早晨,三个决定。
周一 9:00,区域经理 Priya 收到运营工作簿;9:40,她就要主持会议。只有四十分钟,先看什么,才能作出有用的决定?
它先筛出值得关注的门店,再把原因和数据摆清楚,让管理者在采取行动前检查规则是否合理。
- 01
先去看哪三家门店?
筛出最值得优先走访的三家,让会议有明确重点。
- 02
各店工时怎么调整?
根据每周数据,讨论接下来两周各门店的工时安排。
- 03
哪些产品线需要处理?
依据小组终稿中的合成产品数据,筛出需要复核(Review)或下架(Pull)的产品线。
运营界面
三个界面,串起一次决策
先选出优先走访的门店,再查看具体问题,最后检查筛选规则。规则一改,42 家门店的结果就重新计算,方便管理者比较调整前后的差别。
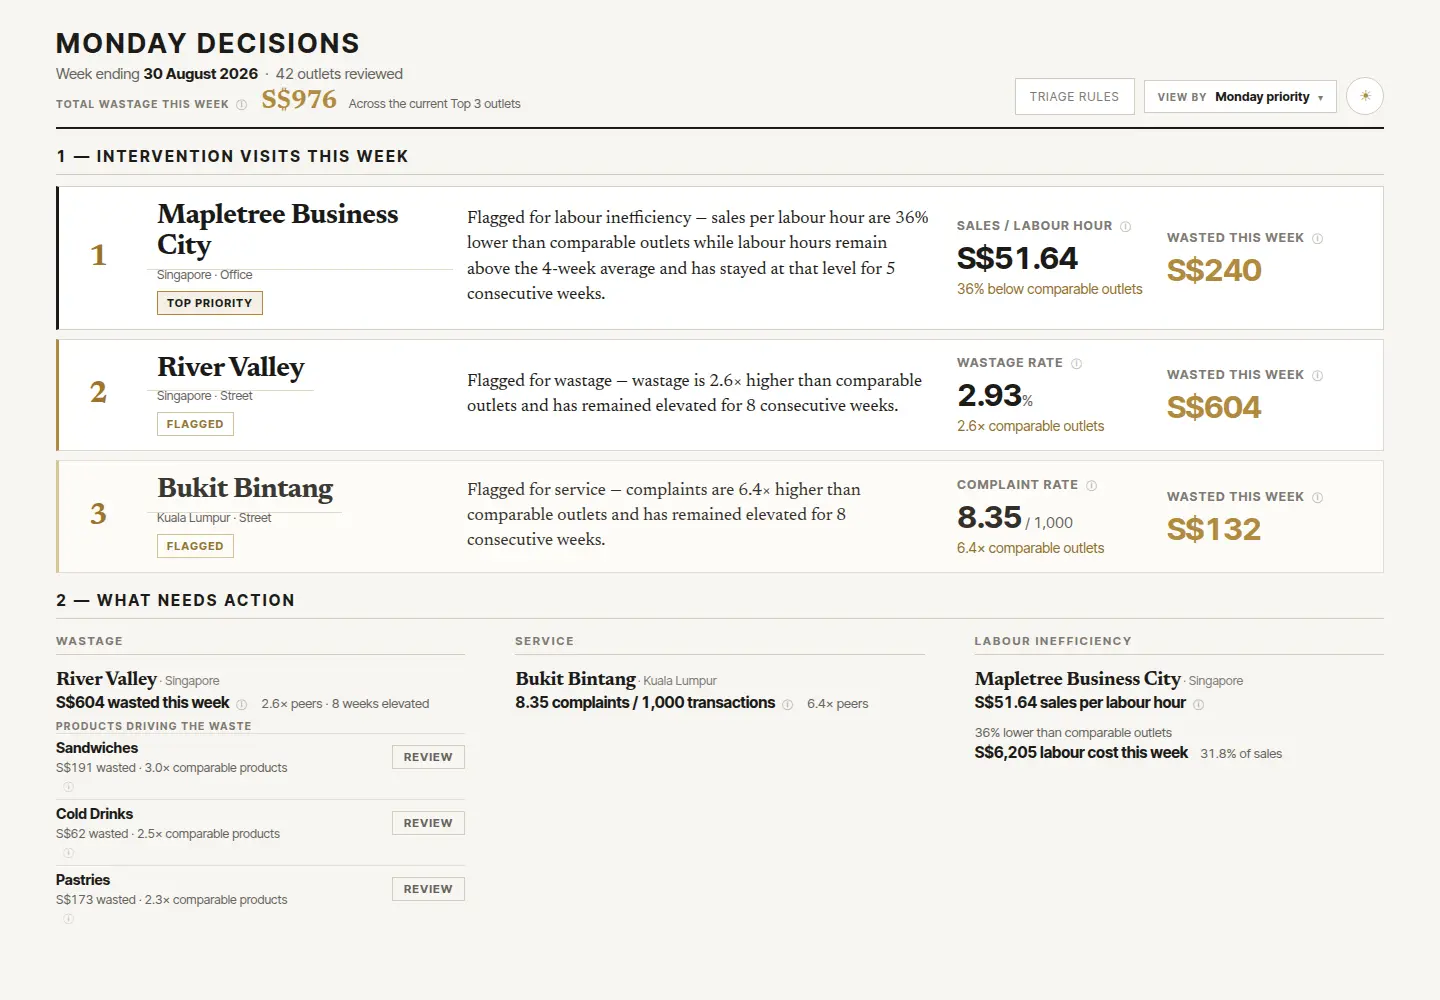
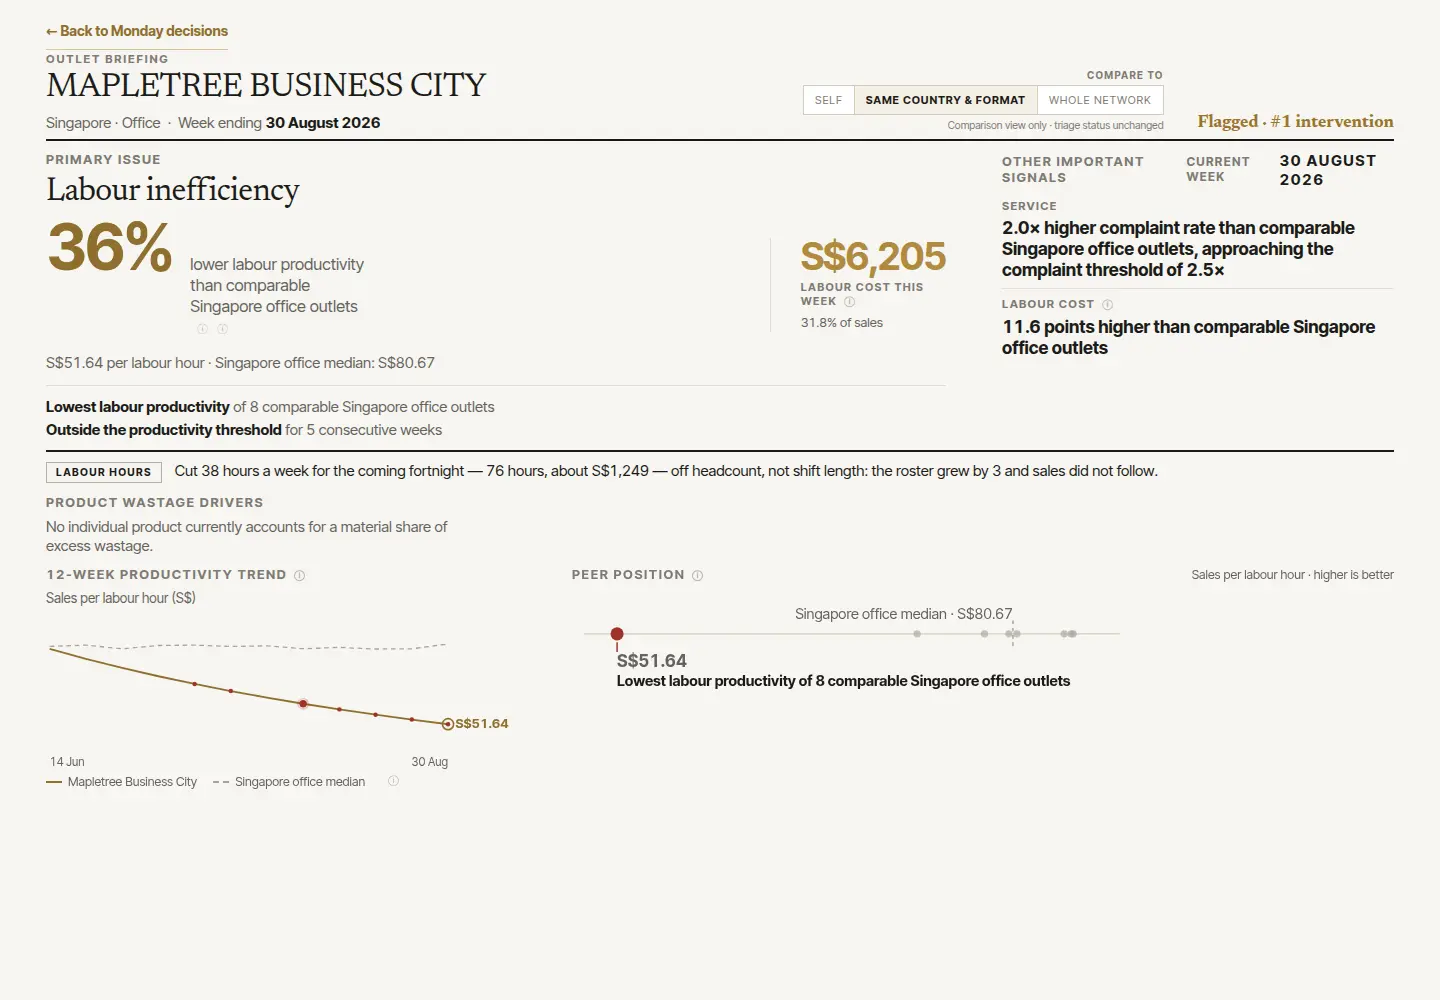
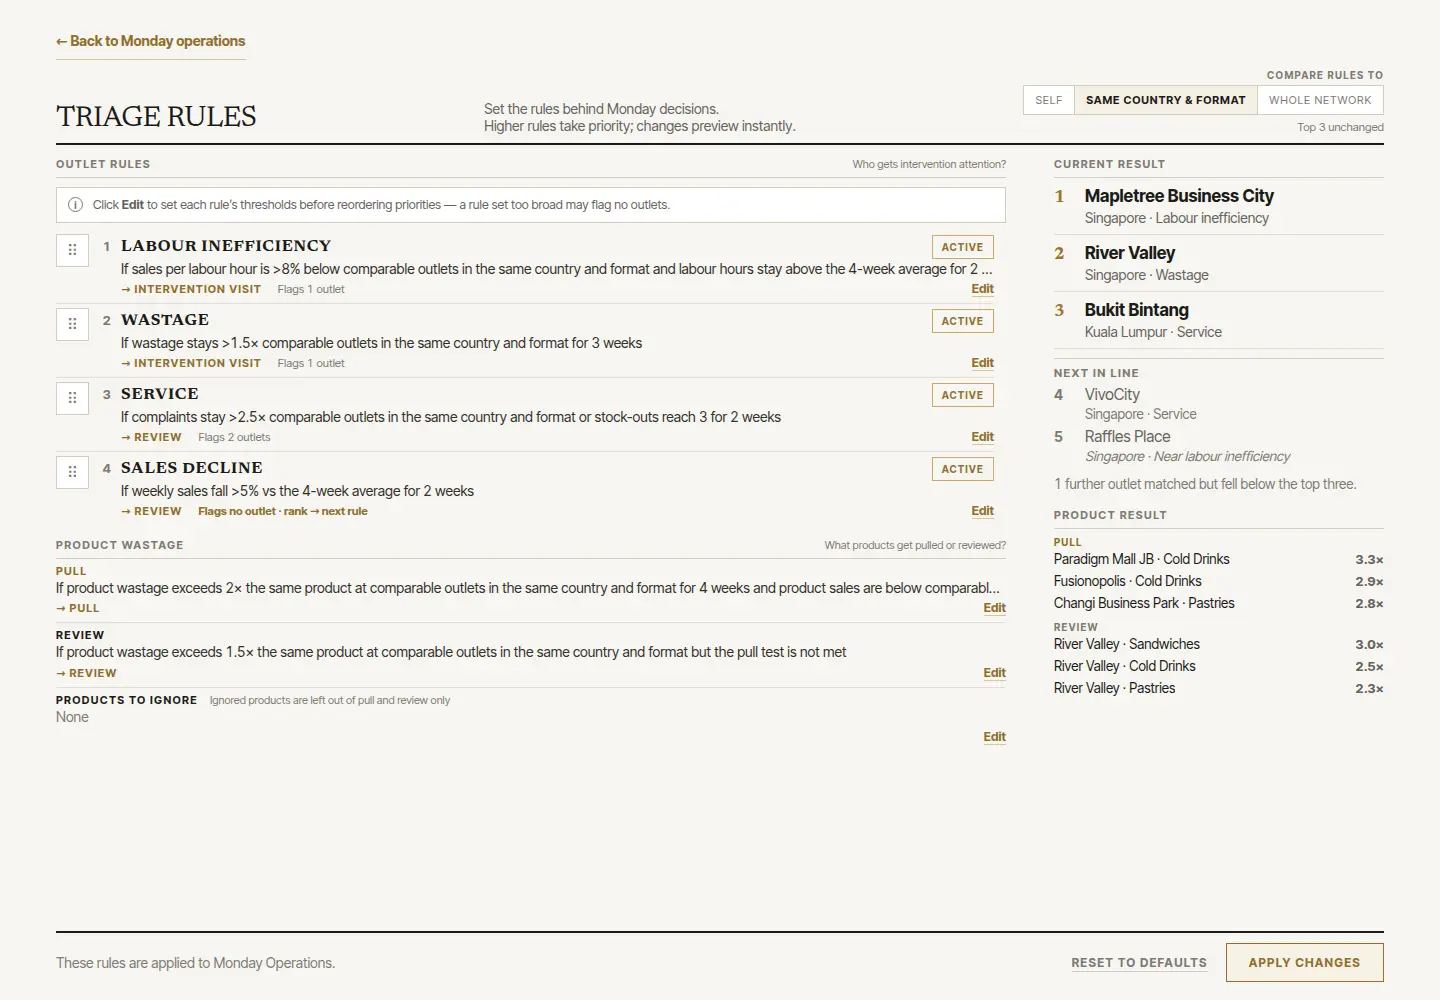
过程档案 / 从材料到判断
把过程打开,看看判断怎么形成。
从原始材料,到个人尝试、团队终稿,再回到复盘。点开一个阶段,看看当时在解决什么问题,依据又在哪里。
504 × 15
做页面之前,先读懂这张表。
42 家门店 × 12 周,共 504 条门店周度记录。
起始数据有 15 个字段。每一行讲的是某家门店在某一周的情况,所以我先关心的是:这一行数据,到底能帮管理者判断什么?
它能帮助找出值得关注的门店,却没有细到具体产品。要决定撤掉哪条产品线,还需要产品层面的依据。这个区别,影响了我最初个人分支的方向,也比先把界面做得更复杂更重要。
V0 / PERSONAL
每一条建议,都得说得出依据。
小组项目中的个人 V0 尝试。
我检查了数据结构,并围绕门店关注顺序和证据能支持的范围,做过自己的 V0 分支。后来再回看,比起「把三屏做满」,更有用的问题是:每一屏到底帮助谁,做出什么决定?
排出名单,要说清为什么值得关注;发现人效异常,还要继续核查调整是否可行;决定撤掉产品,则需要产品层面的证据。页面可以把它们放在一起,推理时却要分别想清楚。
3,024 × 22
终稿更完整,数据版本也要重新看清。
最终原型使用 3,024 条合成产品级记录,共 22 个字段。
团队终稿补充了产品层面的演示数据,让管理者可以在关注名单、门店简报和可调整规则之间切换。本页的三张截图和可操作原型,展示的正是这份共同提交的成果。
几个数据版本的门店 ID 并不连续,不能把它们接成一段真实经营历史。产品表里,同一门店同一周的汇总值还可能在六条产品记录中重复出现;如果直接求和,就会把汇总数据算六遍。表更细了,检查也得跟上。
QUESTION → CHECK
演示顺畅之后,还要继续追问。
事后复盘,把问题定义、证据和交互连起来。
后来从管理问题求解的角度再看这个项目,我更容易讲清楚自己的判断:原始材料、个人探索、小组终稿,以及之后的反思,各自处在什么位置。把过程分开看,才知道哪些做法值得继续保留。
如果再做类似项目,我会先做一个很具体的检查:改一个输入,沿着规则走一遍,再看建议是否真的变化。结果没变,是因为判断合理,还是计算根本没更新?这个问题,也连着网站里其他需求分析和系统工程案例。
依据已提交的项目资料、个人贡献记录及后续复盘整理。截图和原型为团队终稿;本节为事后过程说明。
- 01 / 先选一个问题
- 02 / 再看需要哪些材料
- 03 / 保存理由,比较两版判断
小组终稿 / 可操作原型
这次,你来主持周一会议。
这是我们小组提交的最终原型,保留英文原稿和合成数据。点进一家门店、换一种比较方式,再改一条规则,看看接下来的名单会怎样变化。
- 01 / 先看重点
四十分钟,先看哪三家?
看看每张卡片为什么入选,再用 View by 切换指标,比较不同排序。
- 02 / 再查原因
是自身变化,还是同行差异?
点门店名称,切换 Self、Same country & format 和 Whole network,看看参照对象怎样影响判断。
- 03 / 最后检验
规则改了,结果也该跟着变。
打开 Triage rules,调整条件并预览,再应用修改。这也是我复核原型时特别关注的一步。
我们做错了什么
不只看界面好不好看,也要检查结果对不对。
- 01计算
规则改了,名单却没变
最初版本在规则变化后仍循环使用同一组 Top 3。界面看似动态,名单却几乎是固定的。
修正:数据或规则一旦变化,就从完整数据集重新计算排名。 - 02交互
设计逻辑与用户逻辑互相打架
引擎要求阈值先触发门店,再由优先级排序;管理者却自然会先调整优先级。
修正:提供合理默认值、页面提示和实时影响预览。 - 03证据
数据无法支持每一个答案
门店周度数据能发现浪费和人效问题,但要判断具体产品或安排班表,还需要更细的数据。
修正:透明补充产品层,并把劳动建议限制为每周工时。
证据边界
决策精度不能超过数据精度。
产品
能够支持门店周度数据能识别异常浪费。
无法支持它不能识别具体产品线。
设计回应补充合成产品数据,用于演示复核和下架的筛选规则。
人力
能够支持周度门店数据能识别人效异常。
无法支持它不能生成班次、岗位或员工层面的排班。
设计回应界面只提出有限的周工时建议;具体实施仍由管理者负责。
工具应当帮助管理者分配注意力,而不是替代管理判断。
我的贡献:界面背后的判断
我的个人原型分支聚焦问题界定、分析规则、AI 辅助迭代与批判性复核。本页展示的三个界面来自第 1 组共同提交的最终原型。
先弄清数据能回答什么
在个人分支里,我用 504 条门店周度记录分析问题,区分预警条件和排序规则,也检查这些字段能否支持产品或排班建议。
审视 AI 输出
我检查公式、规则行为、解释、图表与交互状态;修正包括投诉排序的同分处理、夸大的百分比、不合理的负数坐标轴,以及对名单范围表达过度的措辞。
把思路讲清楚
我参与整理提示词和演示内容。项目结束后,又从信息缺口和工作流的角度重新复盘,继续追问原型里还有哪些问题值得解决。
从个人尝试到小组终稿
个人原型
固定的合成门店周度数据:42 家门店、12 周,共 504 条观察。门店编号和分析结果只对应这一分支。
第 1 组终稿
小组终稿使用另一份合成数据:3,024 条产品级记录、22 个字段、6 类产品,覆盖 42 家门店和 12 周,其中新加坡 28 家、新山 7 家、吉隆坡 7 家。门店编号也与个人分支不同。
后续反思
后续的管理问题解决案例再次分析了这个项目,并引入新的分析框架。这里呈现的是项目结束后的思考。
过程 / 贡献
过程与 AI 使用说明
这是一次 AI 辅助的原型冲刺。团队使用生成式工具参与实现、修改、提示词工程与演示制作,并在提交的声明中记录了提示词、失败、修正与人工决定。
我在这个过程中学到,生成一个能看的界面只是开始。还要核对公式和数据,检查规则修改后结果是否真的变化,再把需要管理者判断的部分说明白。
截图采用小组终稿的合成产品级数据,与前述个人分支使用的数据不同。
材料导览 / 顺着内容继续读
案例背后,还可以展开看什么?
每个入口都标明材料类型,可以回看经历,也可以直接操作原型或方法示例。
可操作的小组终稿
打开团队提交的原型,查看合成产品数据与三屏操作。
展开阅读↗02 / 贡献说明我的工作与版本记录
对照个人分支、小组终稿与作者说明,了解各自的工作范围。
展开阅读↗03 / 过程复盘从起始材料到小组终稿
沿着起始数据、个人 V0、小组成果与后续反思,展开过程档案。
展开阅读↗
读完之后 / 接着聊
你会怎样看?
欢迎补充经历、提出问题,或指出需要勘误的地方。中英文页面共用这一篇的讨论。
评论服务尚未开放。可以先写下想法,暂存在本机,或通过联系页发给我。
写一份本机草稿
点击“暂存本机”才会保存。共用设备上请在离开前清除;草稿不会自动发布。
0 / 1600